핵심 요약 · 3줄 체크
- 01허브-스포크 구조는 핵심 서비스·가이드 페이지(허브)와 세부 질문 글(스포크)을 양방향 링크로 묶어 주제 맥락을 전달하는 설계입니다.
- 02다른 페이지의 내부 링크를 전혀 받지 못하는 고아 페이지와 너무 깊은 경로 끝에 놓인 페이지는 사용자와 크롤러가 사이트 내 탐색 중 발견하기 어렵습니다.
- 03앵커 텍스트는 '자세히 보기' 대신 목적지 주제가 드러나는 문구로 쓰고, 비표준 클릭 스크립트 대신 표준 <a href> 요소를 사용합니다.
1. 고아 페이지와 탐색 깊이가 검색 탐색을 막는 이유
내부 링크 설계는 같은 도메인 안의 페이지들을 목적과 주제 관계에 따라 연결해 검색 크롤러와 독자가 문서를 발견하고 페이지 사이의 관계를 이해하도록 돕는 구조 작업입니다. Google SEO 기본 가이드(2026년 11월 확인 기준)는 검색엔진이 새로운 페이지를 찾으려면 다른 페이지로부터 연결된 링크가 필요하다고 안내합니다. 예를 들어 블로그 글이나 제품 공지를 꾸준히 올리면서 관련 서비스·요금·도입 문의 페이지로 가는 링크나 글끼리의 연결을 빼먹으면 사이트 안에 고립된 문서가 쌓입니다.
어떤 다른 페이지로부터도 내부 링크를 받지 못하는 문서를 **고아 페이지(Orphan Page)**라고 합니다. 고아 페이지는 사이트맵에 들어 있더라도 방문자와 크롤러가 홈페이지에서 링크를 타고 이동하는 경로가 끊겨 있어 발견이 늦어지거나 중요도 신호를 받기 어렵습니다. 또한 홈페이지에서 여러 번 연속 클릭해야 겨우 닿는 깊은 페이지(Deep Click Depth)는 사용자도 찾아가기 어렵습니다. Google이 특정 클릭 횟수(예: 3클릭 vs 4클릭)를 크롤링 중단 기준으로 명시한 것은 아니지만, 핵심 전환 페이지와 주요 가이드 문서는 홈페이지 기준 3클릭 이내처럼 얕은 경로에서 닿도록 정보 구조를 짜는 것이 사용자와 크롤러 모두에게 유리한 설계 목표 예시입니다.
2. B2B·중소기업 사이트의 허브-스포크 배치표
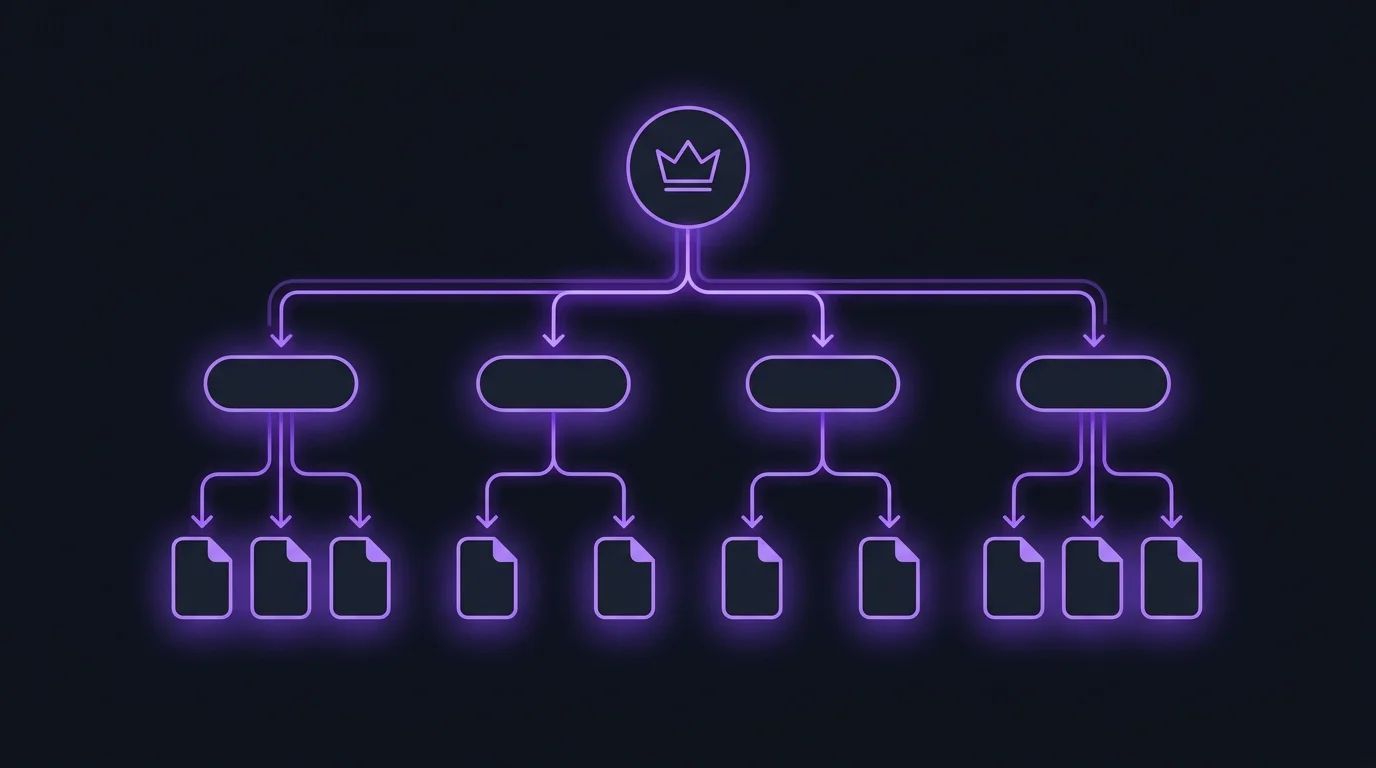
허브-스포크(Hub & Spoke) 구조는 넓은 주제를 대표하는 1개의 중심 페이지(허브)와 그 안의 구체적 질문·사례·절차를 하나씩 풀어서 답하는 여러 하위 글(스포크)을 양방향 내부 링크로 연결하는 배치 방식입니다. 허브는 스포크들로 내려가는 목차·안내 링크를 두고, 각 스포크 글은 본문 안의 적절한 맥락에서 다시 허브 페이지로 올라가는 링크와 인접 스포크로 이동하는 링크(예시로 1~2개)를 자연스럽게 갖춥니다.
예를 들어 중소기업용 클라우드 ERP를 공급하는 회사가 /services/erp/를 허브로 삼는다면, 도입을 검토하는 담당자의 세부 질문 네 가지를 스포크 글로 나누어 아래 표처럼 연결할 수 있습니다.
| 구분 | 예시 URL | 담당 질문 | 연결할 링크와 위치 |
|---|---|---|---|
| 허브 | /services/erp/ | ERP 기능·적용 업종·도입 흐름 전체 | 본문 각 기능 절에서 아래 스포크 4편으로 연결 |
| 스포크 1 | /blog/erp-cost-factors/ | 사용자 수·모듈별 도입 비용 산정 기준 | 허브(/services/erp/) + 스포크 4(이관 체크리스트) |
| 스포크 2 | /blog/erp-accounting-sync/ | 국세청 홈택스·기존 회계 연동 방식 | 허브(/services/erp/) + 스포크 3(보안 인증) |
| 스포크 3 | /blog/erp-security-audit/ | 권한 관리·로그 보관·보안 점검 기준 | 허브(/services/erp/) + 스포크 2(회계 연동) |
| 스포크 4 | /blog/erp-data-migration/ | 기존 엑셀 거래처·재고 이관 절차 | 허브(/services/erp/) + 스포크 1(비용 산정) |
이 예시 구조에서는 블로그 글 하나를 읽고 들어온 방문자가 자연스럽게 핵심 서비스 소개(/services/erp/)와 다음 판단 단계 글로 이어집니다. 예를 들어 한 주제 묶음의 스포크 글이 10편 안팎 이상으로 늘어나면 한 허브 페이지에 목록만 길게 세우기보다 세부 주제별 하위 허브를 나누어 독자의 탐색 단계를 간결하게 유지할 수 있습니다.
3. 크롤러와 독자가 이해하는 앵커 텍스트와 HTML 링크 규칙
Google의 크롤링 가능한 링크 안내(2026년 11월 확인 기준)에 따르면 Googlebot은 표준 HTML <a href="..."> 요소에서 링크 URL을 일관되게 추출해 따라가지만, JavaScript의 onclick 이벤트나 href="#" 위에 스크립트만 덧씌운 UI 버튼은 크롤러가 링크로 안정적으로 발견·해석하지 못할 수 있습니다. 또한 Google은 링크 단어 자체(앵커 텍스트)와 함께 링크가 놓인 앞뒤 문장 문맥 및 접근성 문구를 참고해 도착 페이지의 주제를 파악합니다.
- 피해야 할 앵커 텍스트 · 주변 맥락 없이 “여기를 클릭하세요”, “자세히 보기”, “관련 글 링크”만 쓰거나 URL 주소 그대로(
https://example.com/post-12) 붙여 넣기 - 권장하는 앵커 텍스트 · “ERP 도입 전 엑셀 재고 데이터 이관 체크리스트”, “요금제별 API 연동 범위 비교”처럼 도착 페이지의 핵심 주제가 자연스럽게 드러나는 문구
- 내부 리다이렉트·오류 정리 · 본문 내부 링크가 옛 주소(
301)나 삭제된 페이지(404)를 가리키지 않게 최신 정규 URL로 바로 연결 - 문맥 중심 연결 · 정해진 링크 개수 제한은 없으나, 본문 뜻과 무관한 키워드 링크를 한 글에 과도하게 나열하기보다 독자가 실제로 다음 행동을 고민할 지점에 2~5개 예시 수준으로 배치
아래 두 HTML 예시를 비교해 보면 차이가 분명합니다. 첫 번째는 스크립트 클릭 이동과 모호한 문구를 써서 크롤러와 독자 모두 목적지를 알기 어렵고, 두 번째는 표준 <a href> 요소와 설명형 앵커 텍스트, 앞뒤 문맥으로 주제를 전달합니다.
<!-- 피해야 할 형태: 비표준 클릭 이동 + 모호한 문구 -->
<span onclick="goPage('/blog/erp-data-migration/')">자세히 보기</span>
<!-- 권장 형태: 표준 <a href> + 설명형 앵커 텍스트와 주변 문맥 -->
<p>기존 거래처 목록을 옮기는 순서가 필요하면 <a href="/blog/erp-data-migration/">ERP 초기 데이터 이관 절차</a>를 먼저 확인하세요.</p>
4. 고아 페이지 대조와 내부 링크 5단계 점검 체크리스트
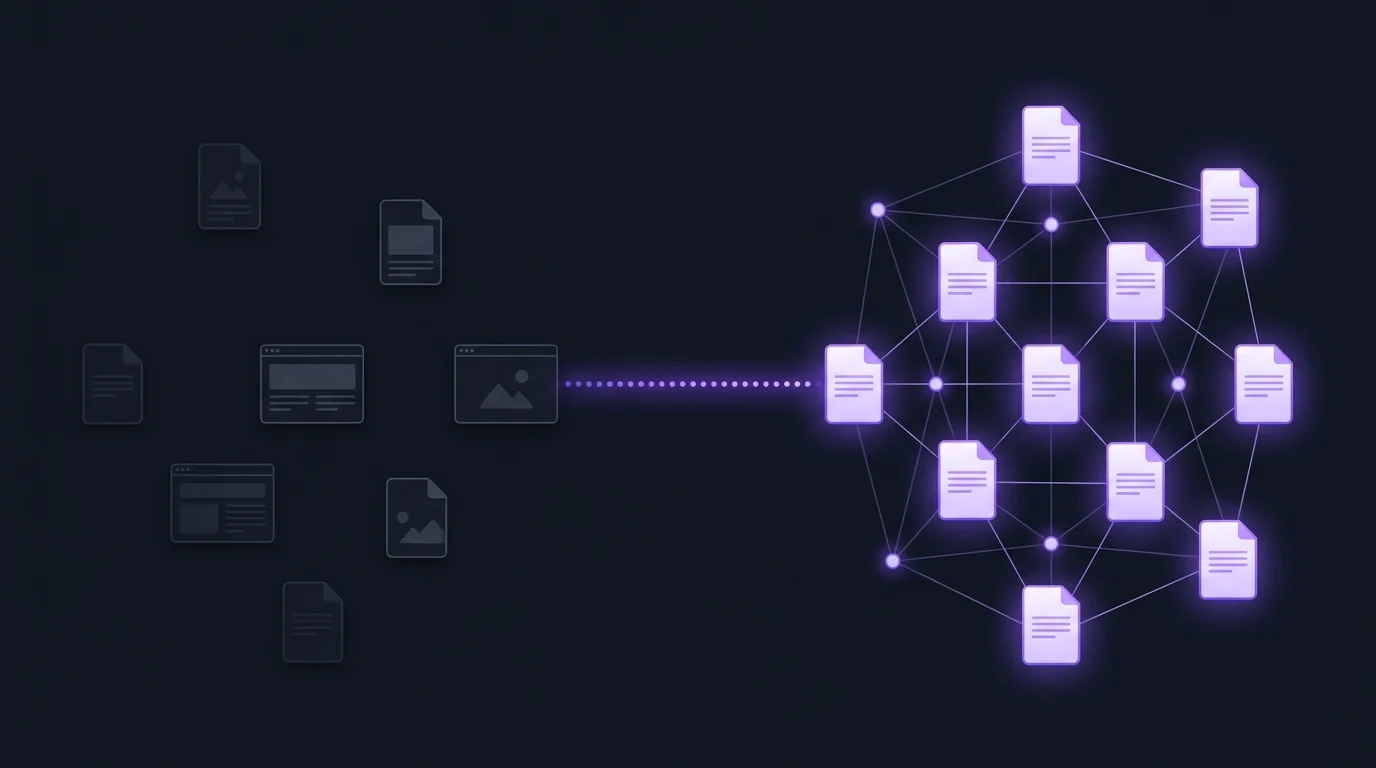
sitemap.xml 목록만 열어 봐서는 어떤 페이지에 내부 링크가 몇 개 연결되어 있는지 알 수 없습니다. 고아 페이지와 탐색 깊이를 실제로 찾아내려면 “전체 공개 URL 목록”과 “홈페이지 기준 내부 링크 크롤링 결과”를 대조해야 합니다. 한 달에 한 번 또는 카테고리 개편 시점에 아래 다섯 단계를 차례로 실행합니다.
- 전체 공개 URL 기준 목록 확보:
sitemap.xml또는 CMS 게시물 내보내기(CSV)로 현재 공개 중인 정상 페이지(HTTP 200) 전체 URL 목록을 모읍니다. - 홈 기준 내부 링크 크롤링 및 대조: 로컬 사이트 크롤러나 내부 점검 스크립트로 홈페이지(
/)에서 출발해<a href>링크만 따라 크롤링하고 각 URL의 유입 내부 링크 수(Inlinks)와 홈 기준 클릭 단계를 추출합니다(크롤러 실행이 어려운 소규모 사이트는 Google Search Console링크 > 내부 링크 > 상위 연결된 페이지내보내기 표와 CMS 전체 URL 목록을 스프레드시트MATCH함수 등으로 대조해 보조로 점검할 수 있습니다). - 고아 페이지와 깊은 문서 분류: 1번 전체 목록에는 있지만 2번 크롤링 결과에서 유입 내부 링크가 0개로 나오거나 여러 단계를 거쳐야 닿는 핵심 페이지를 작업 목록으로 뽑습니다.
- 허브·스포크 본문 링크 연결: 고립된 글을 관련 서비스·제품 허브 페이지 본문이나 카테고리 안내 문단에 표준
<a href>와 설명형 앵커 텍스트로 연결하고, 스포크 글에서도 허브와 연관 스포크로 이어지게 보완합니다. - 재크롤링 및 오류 링크 정리: 수정 배포 후 다시 크롤링(또는 URL 검사)해 고아 페이지의 유입 링크가 1개 이상 생겼는지 확인하고, 본문 내부 링크 중
301리다이렉트나404를 반환하는 옛 주소를 최종 정규 URL로 교체합니다.
검색 콘텐츠를 작성하기 전에 기존 URL과 질문을 짝짓는 방법은 검색 콘텐츠 기획, 본문 문단을 질문과 근거로 나누는 법은 질문형 콘텐츠 구조, JavaScript 링크 렌더링 확인은 JavaScript SEO에서 이어서 확인할 수 있습니다.
참고 자료(2026년 11월 확인 기준): Google SEO 기본 가이드, Google 크롤링 가능한 링크 가이드.
자주 묻는 질문
글 하단의 '관련 글 추천' 위젯이나 사이드바 링크만 있으면 본문 링크는 안 넣어도 되나요?
위젯이나 공통 내비게이션도 URL 발견에는 도움이 되지만, 본문 문맥 속에서 주변 문장과 함께 놓이는 링크가 도착 페이지의 주제를 훨씬 명확하게 설명합니다. 핵심 허브 페이지와 가장 밀접한 스포크 글은 본문 문장 안에 설명형 앵커 텍스트로 직접 연결하는 편이 좋습니다.
한 페이지에 내부 링크가 너무 많으면 감점되나요?
Google 문서상 페이지당 허용 링크 개수의 고정 기준은 없습니다. 다만 문맥과 무관한 링크를 무작정 많이 넣기보다, 이 예시처럼 독자가 실제로 다음 판단을 내리는 데 필요한 연관 문서 몇 곳(예: 2~5개 수준)으로 좁혀 배치하면 가독성과 주제 집중도를 지키기 좋습니다.
로그인이나 장바구니 링크에는 rel="nofollow"를 붙이면 색인에서 빠지나요?
아닙니다. rel="nofollow"는 링크 관계에 대한 힌트일 뿐 로그인·회원가입·장바구니 페이지의 색인이나 접근 자체를 막지 못합니다. 검색 결과에서 빼야 하는 경로는 noindex로, 접근 자체를 막아야 하는 경로는 로그인 인증으로 처리합니다. robots.txt는 크롤링 요청을 줄일 뿐 검색 결과 제외를 보장하지 않으며, 정상적인 공개 콘텐츠 간 내부 링크에는 nofollow를 붙이지 않습니다.